
一、开始前的准备
1. ChatGPT 桌面应用
安装新版 ChatGPT 桌面应用(之前叫Codex,现在合并了)
Windows在微软商店进行安装
Mac端、Win端用户都可以访问:
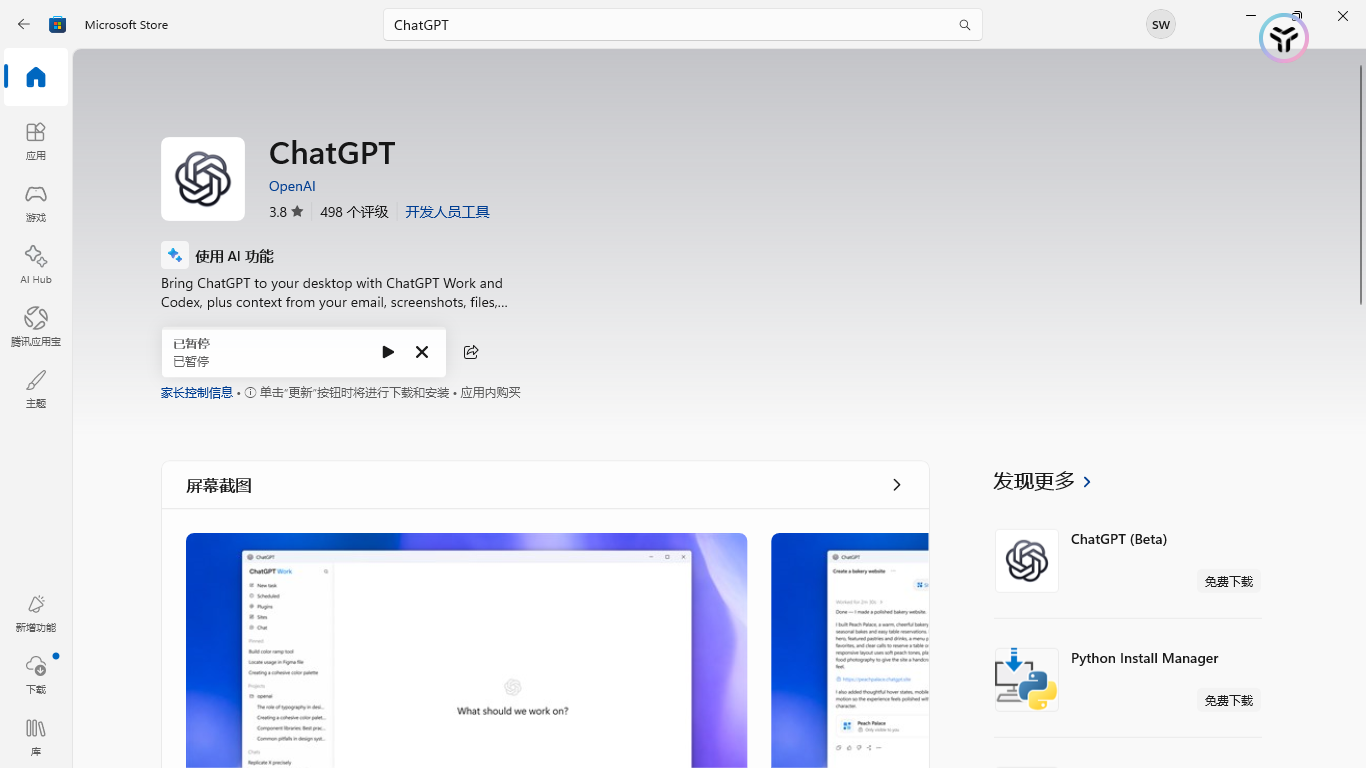
国内环境访问不了的,可以试试通过我的压缩包解压Codex install安装包
2. CC Switch
本文建议使用 CC Switch 3.16.1 或更高版本,建议直接安装最新稳定版。
3.16.0 版本开始支持把 Codex 的 Responses API 请求转换为 DeepSeek 等供应商使用的 Chat Completions 请求;不需要再结合Codex++等其他软件了
打开👇官方仓库首页:
或者直接访问安装包首页然后选择最新版本安装:
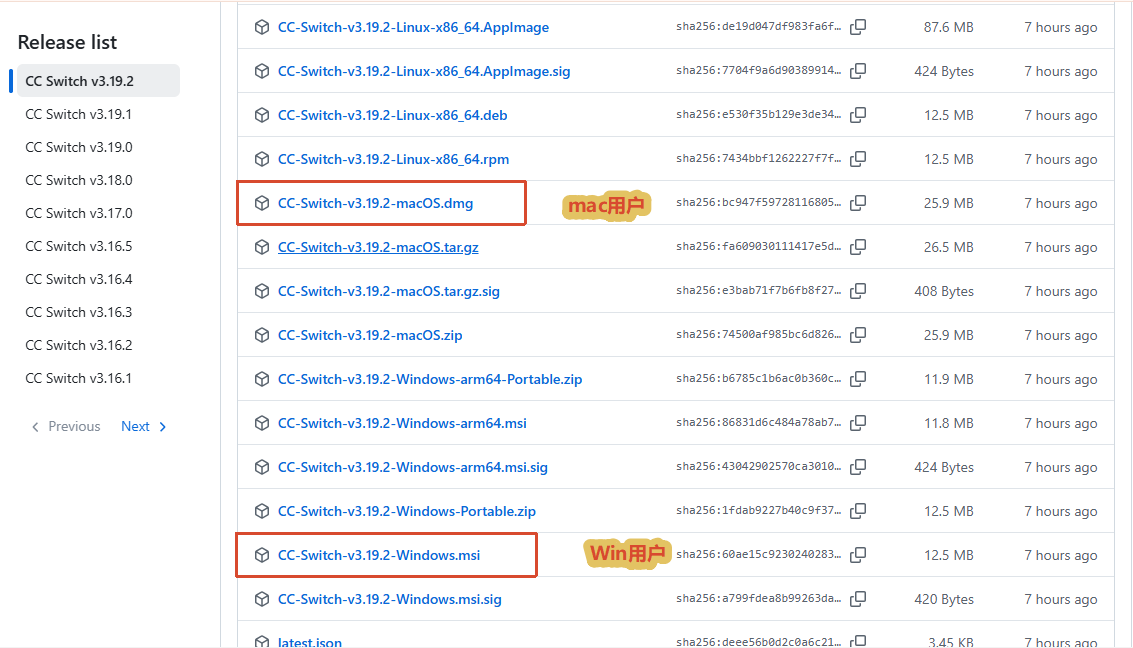
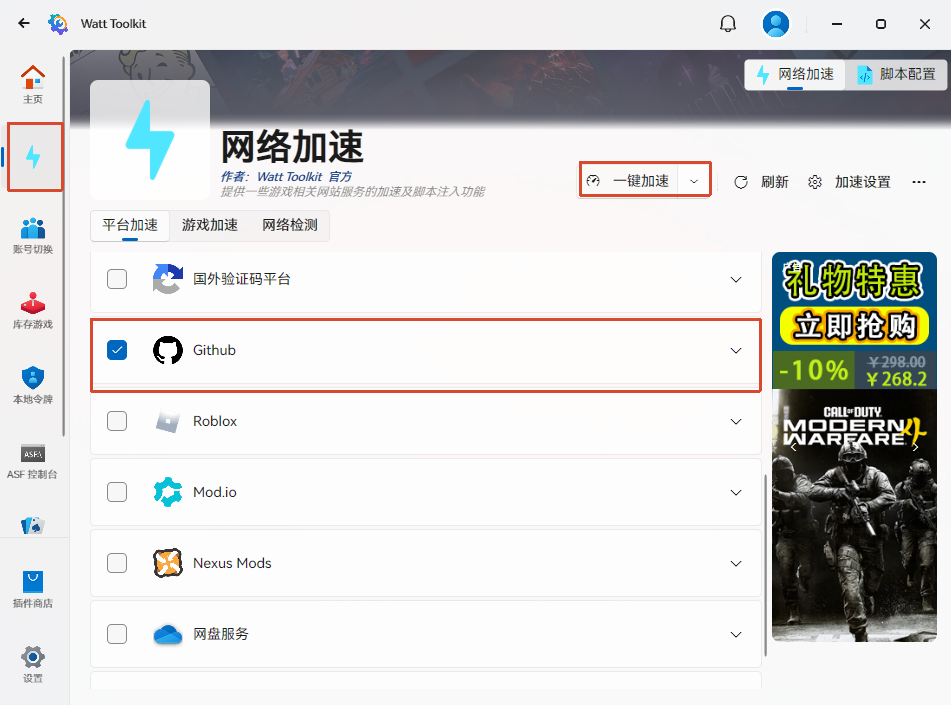
国内网络问题加载缓慢的可以下载下面这个Watt Toolit软件进行加速(GitHub)
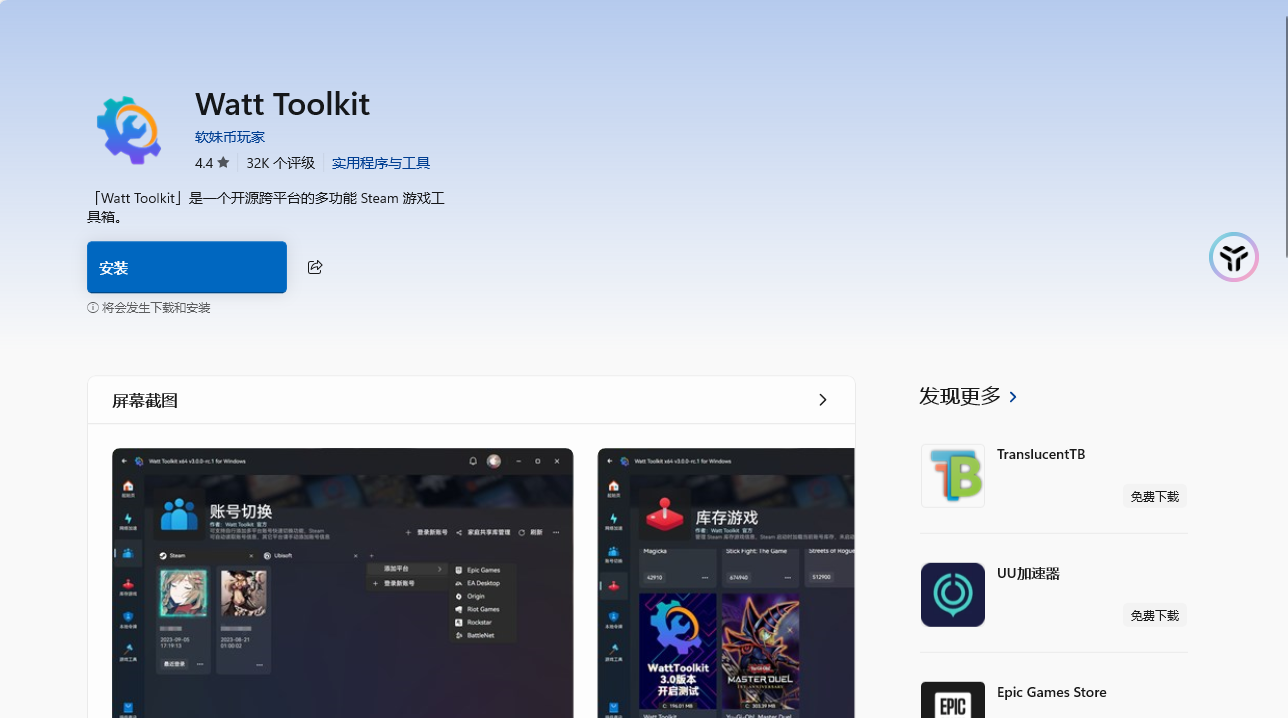
安装好后不需要注册即可免费开启加速访问GitHub
安装完成后打开CC Switch即可
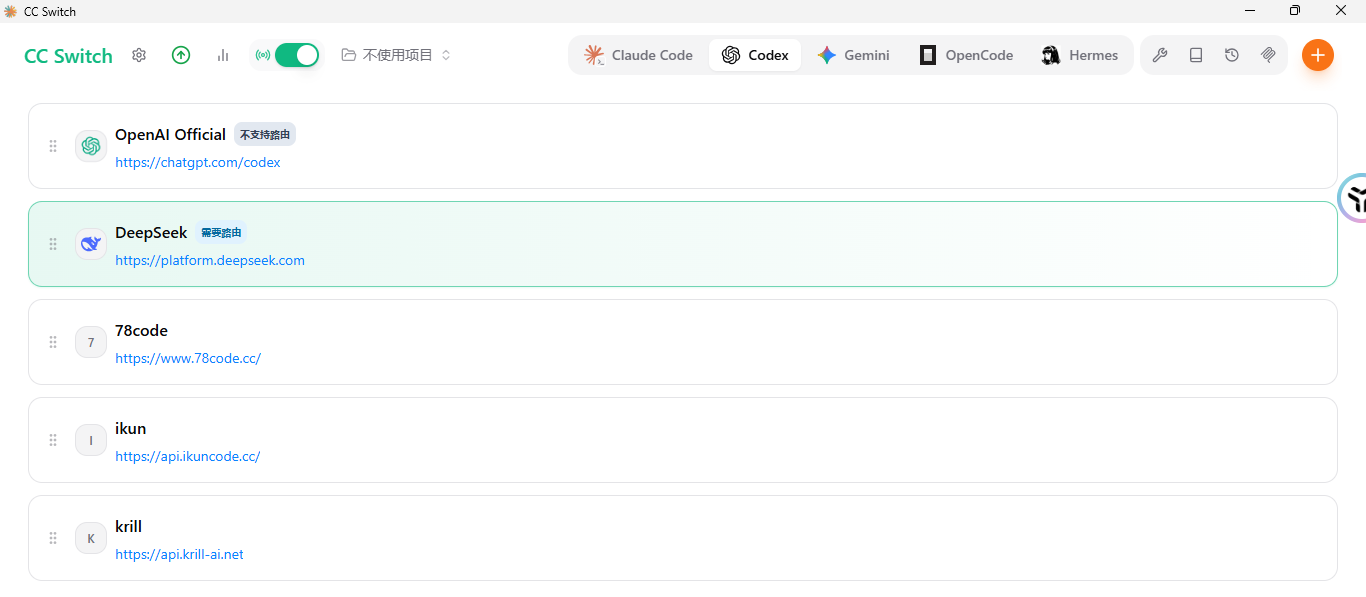
刚开始进入是空白的,因为DeepSeek等客户端还没有进行配置(后文会交代配置)
3. DeepSeek API Key
API Key获取地址:
需要在 DeepSeek API 控制台中创建 API Key,并保证账户有可用余额。API 调用会根据实际 token 使用量计费。
4. Zotero
准备zotero桌面版,没有的可以到官网下载
二、开始配置
1. 在CC Switch中添加 DeepSeek 供应商
到DeepSeek开放平台认证好个人信息后,创建API Key,名称任意填写
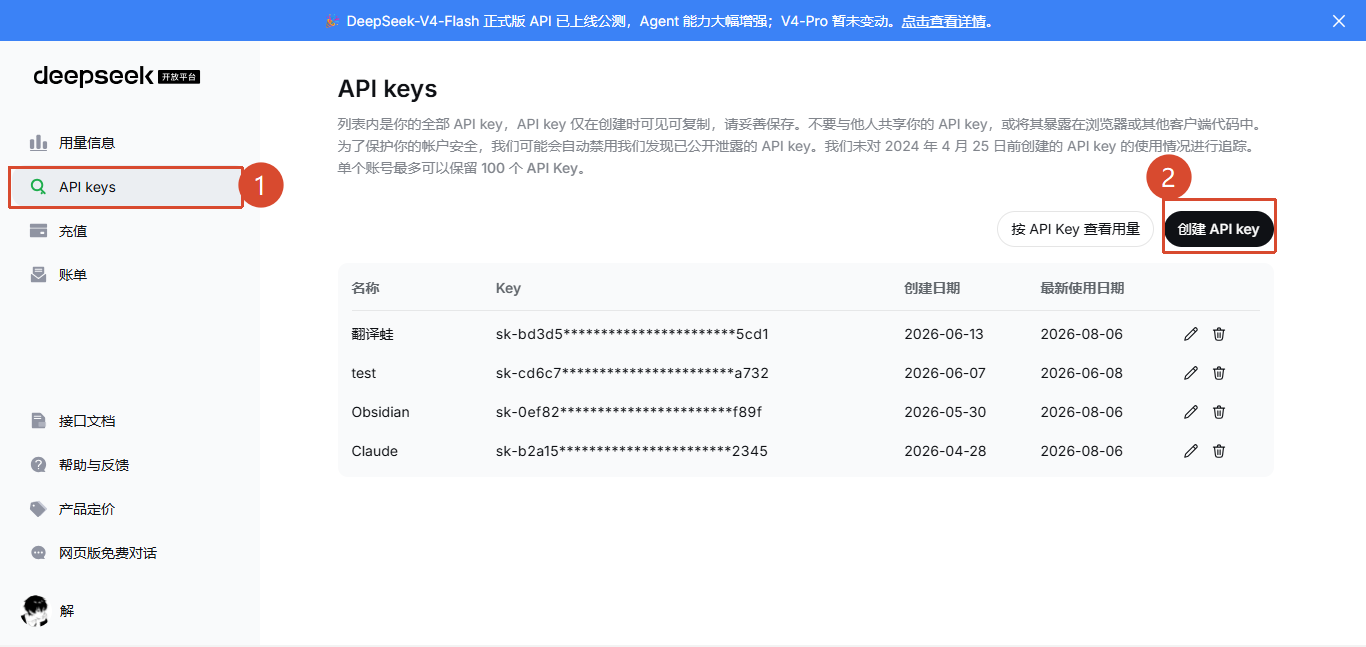
API Key只会出现一次,记得复制好保存到其他地方,不要泄露!
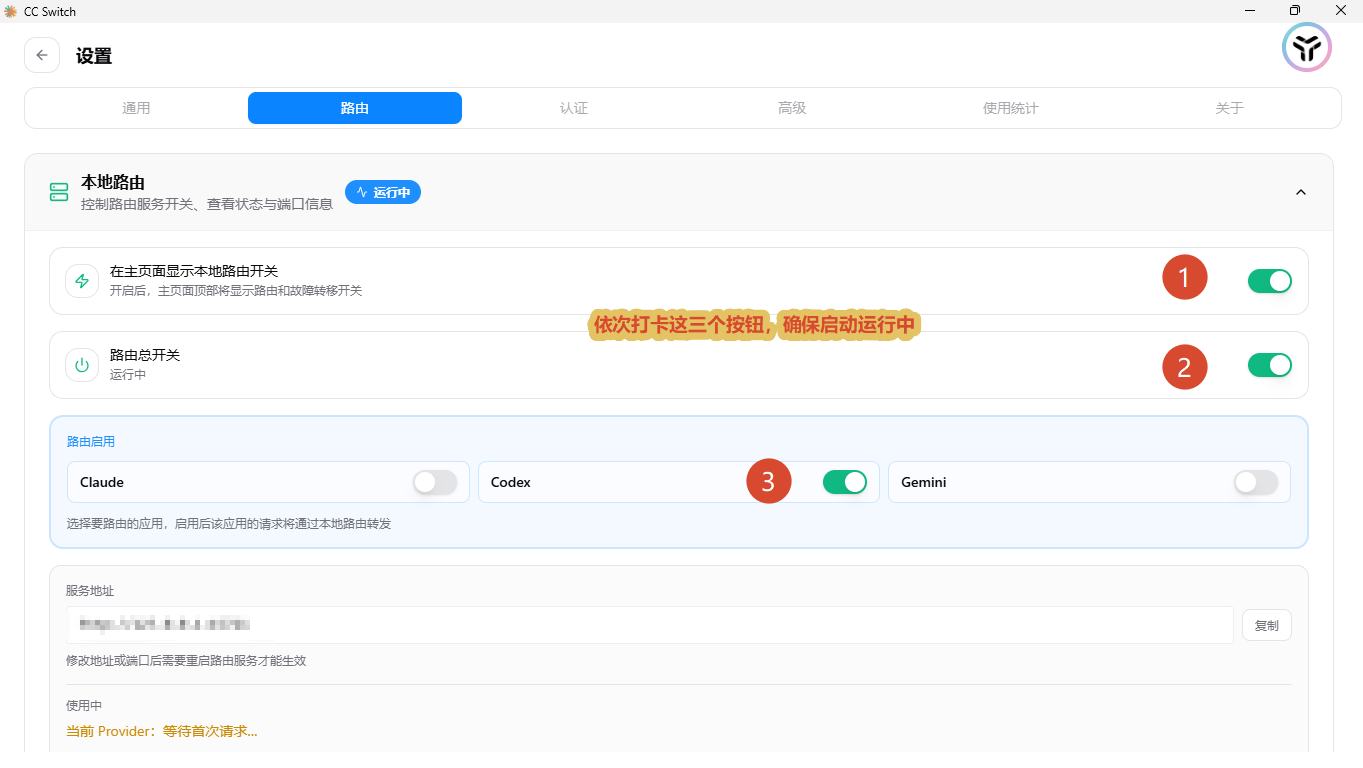
回到CC Switch,在顶部点击左上角齿轮⚙️图标打开设置
回到首页,选择Codex,点击右上角的加号,添加新的供应商。
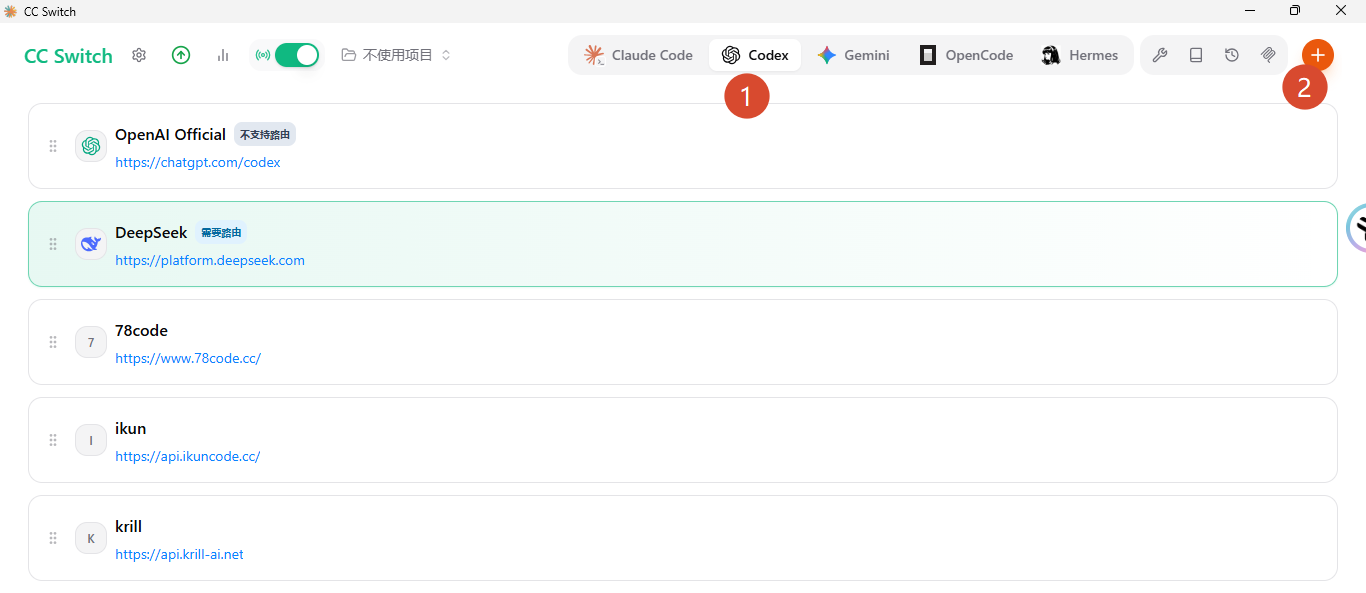
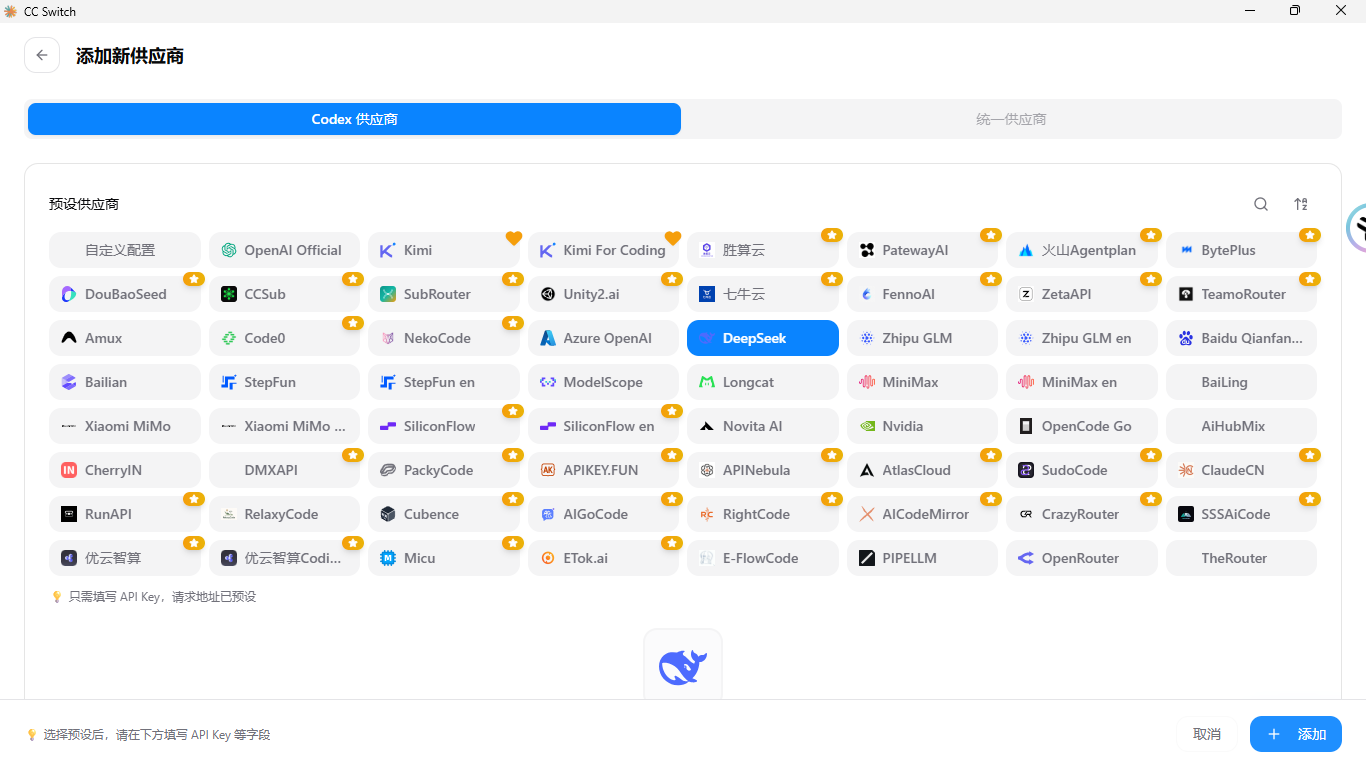
找到DeepSeek
然后填写自己的 DeepSeek API Key。
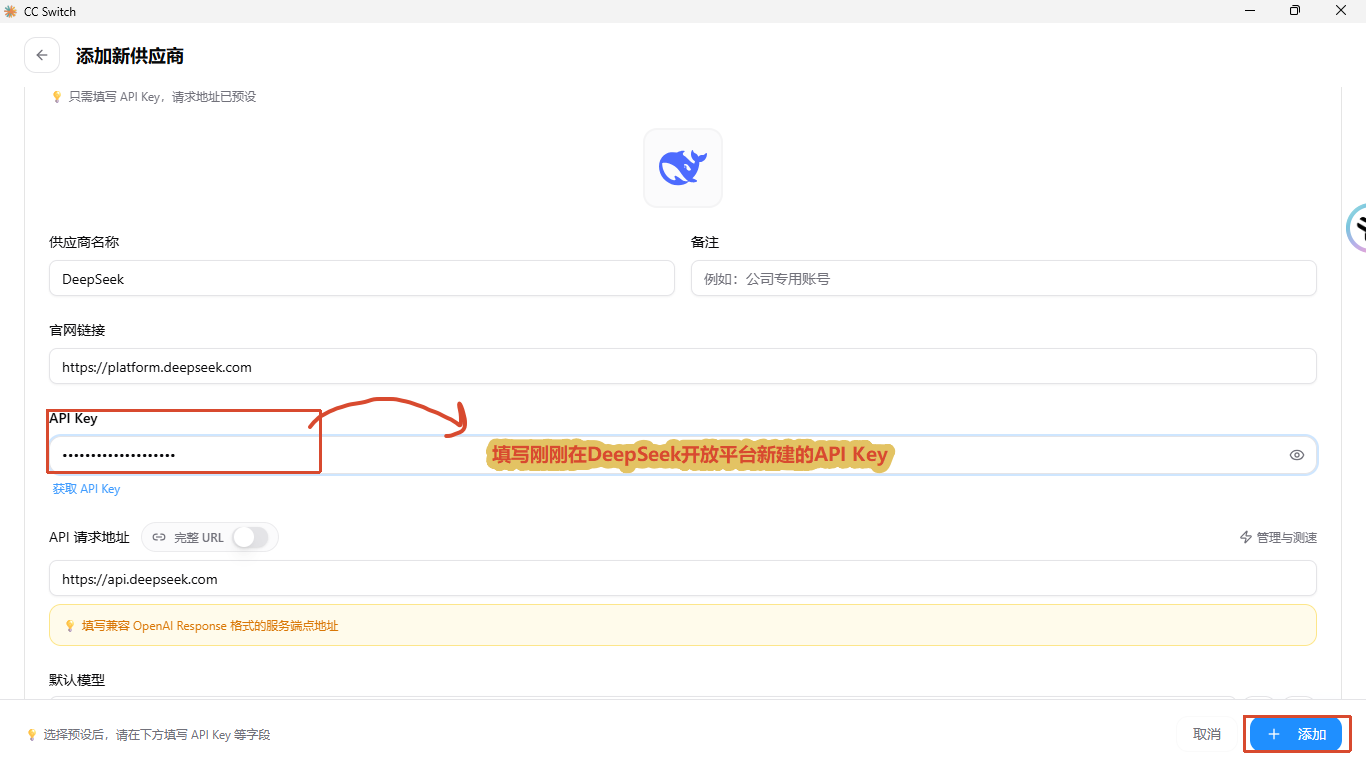
其他配置尽量保持预设值,然后添加即可
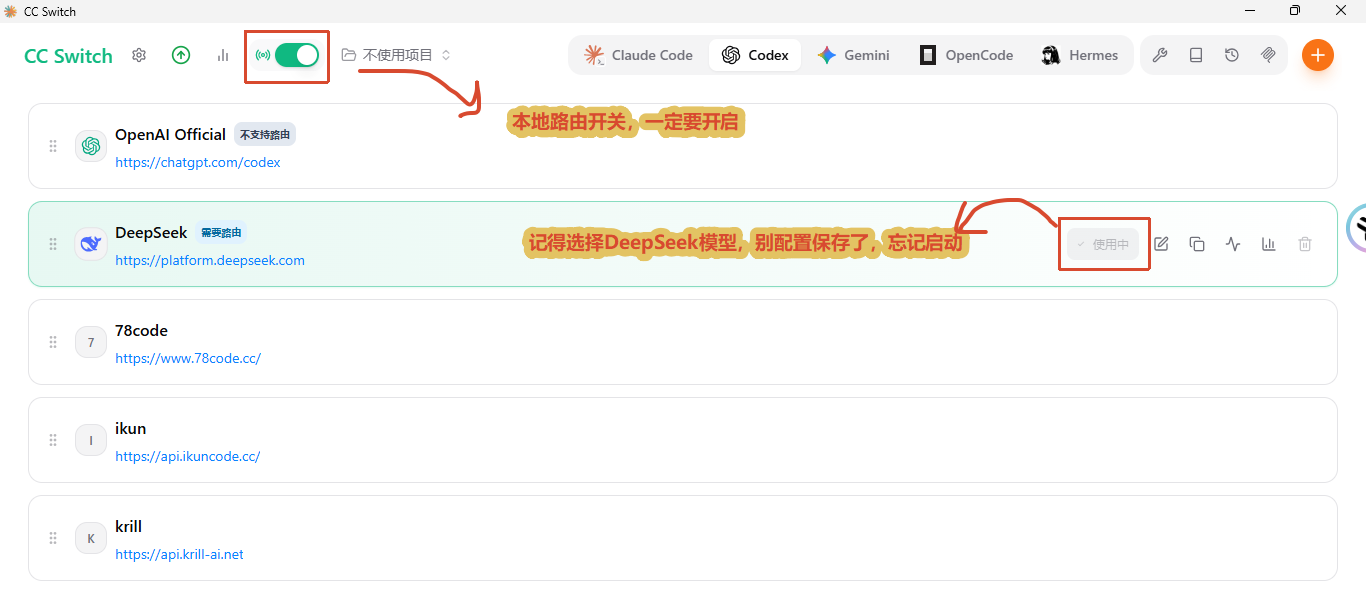
DeepSeek 官方提供的是 OpenAI Chat Completions 兼容接口,而 Codex 主要按照 OpenAI Responses API 发送请求。两种协议的请求体、流式事件和工具调用格式并不相同,所以我需要开启本地路由接管本地使用Codex发送的请求和DeepSeek 发送的回复
因此要保证首页左上角这个图标是开启的,同时确保选中开启的是的DeepSeek模型
2. 打开Codex客户端
启动Codex APP,如果已经开启,需要在DeepSeek配置并启动后重新启动客户端
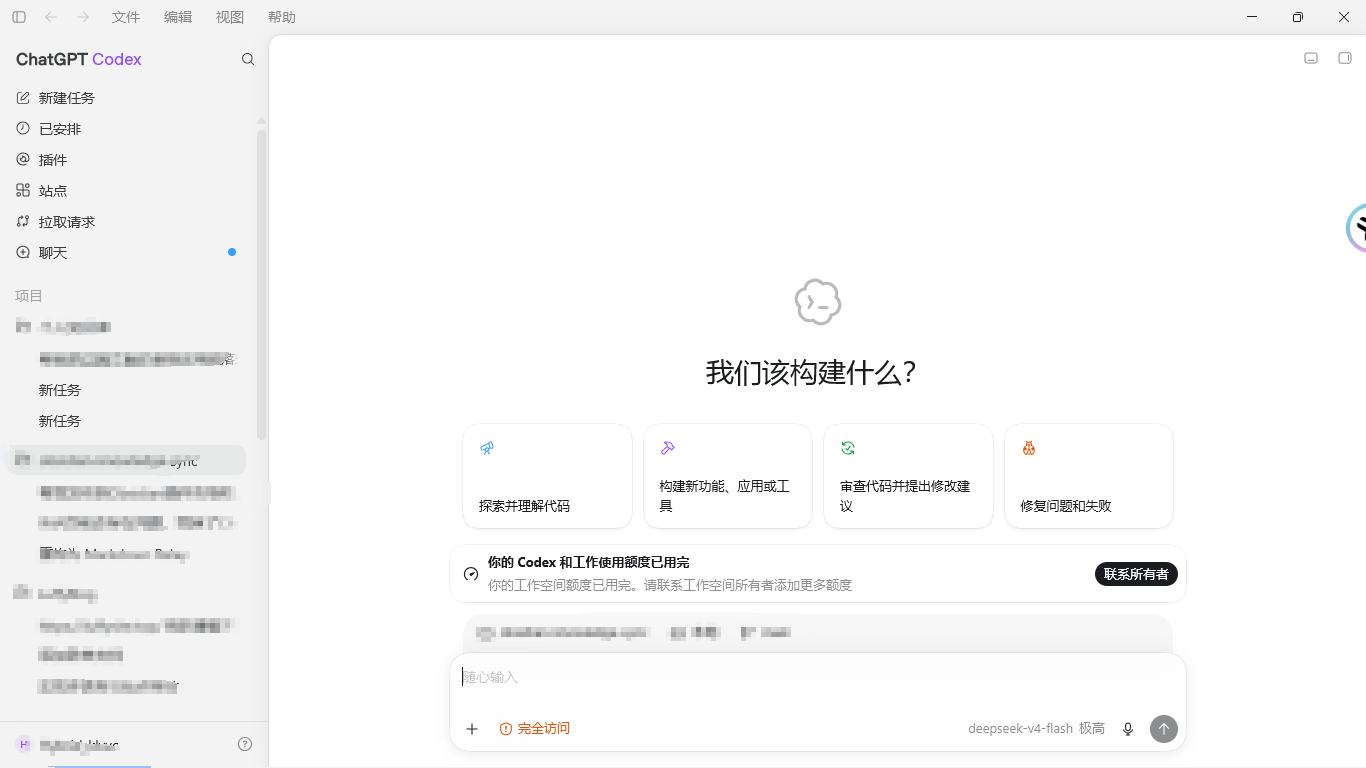
前面操作没有问题是可以直接正常打开访问的
然后点击左侧栏插件,然后搜索
Zotero,进行安装即可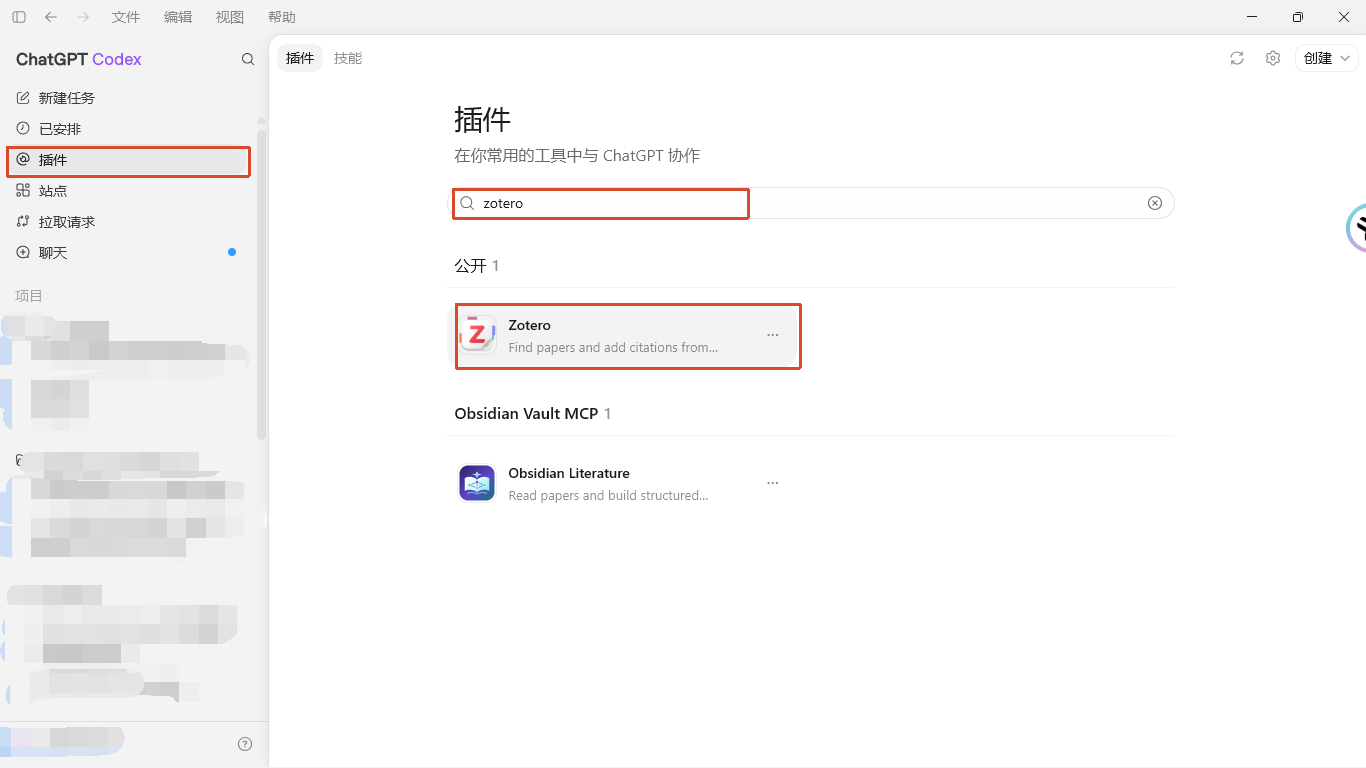
做完这一步已经整个流程已经搞定了
保险起见,可以打开Zotero的设置,打开这个选项,可以让zotero的文献暴露给Codex访问,DeepSeek也能间接读取zotero文献
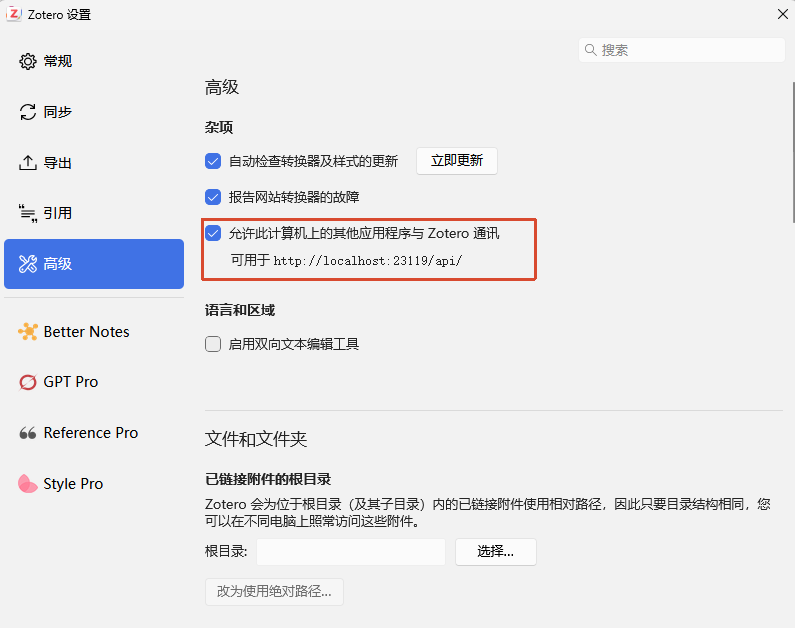
使用演示
直接在对话框开头输入
@zotero ,引用插件即可,选择最上面那个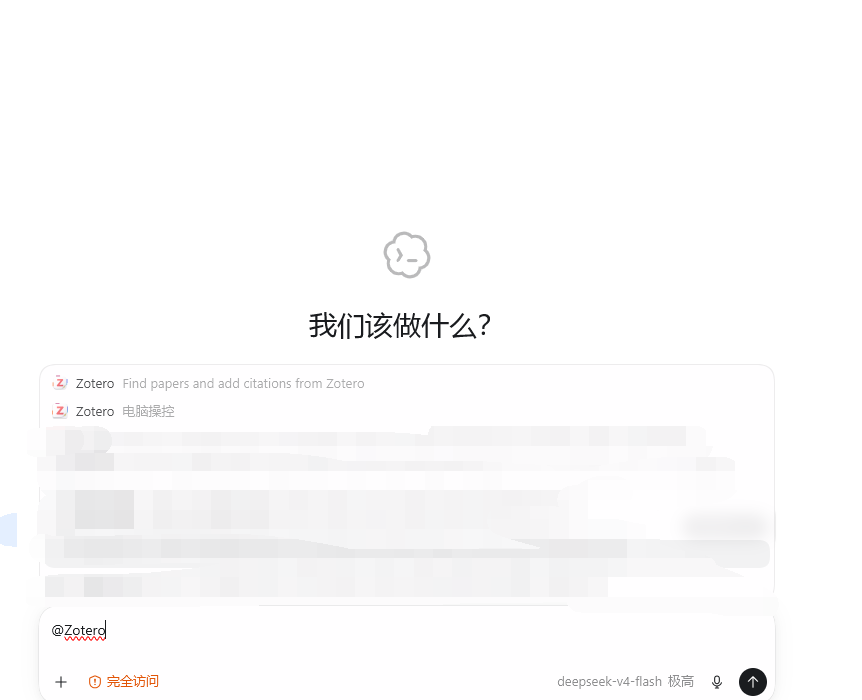
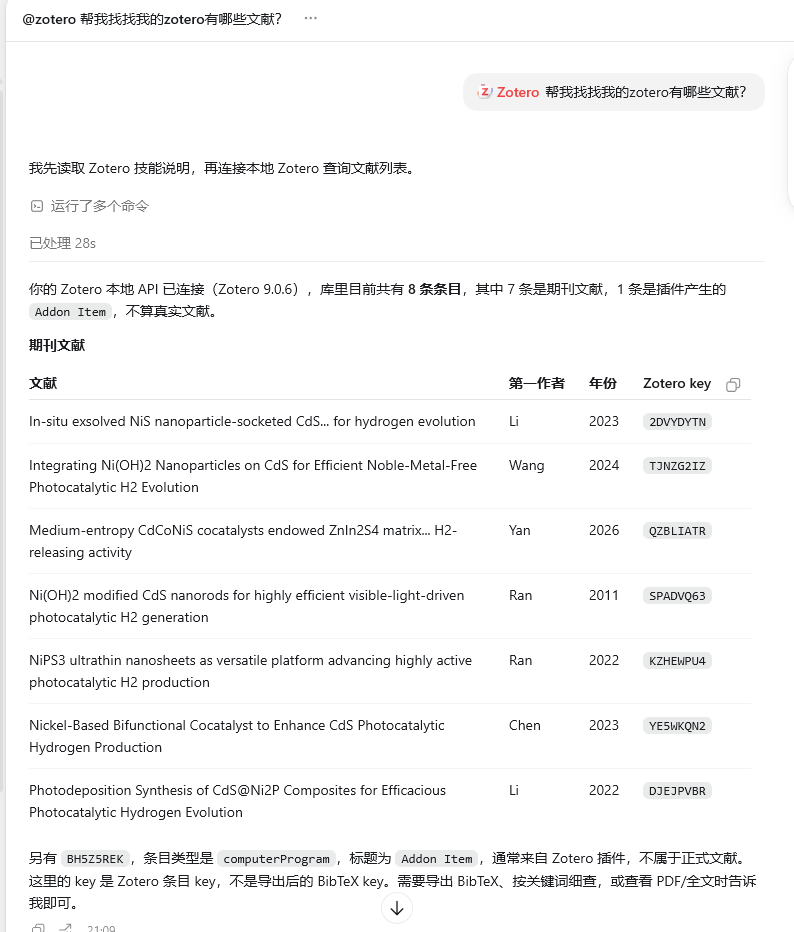
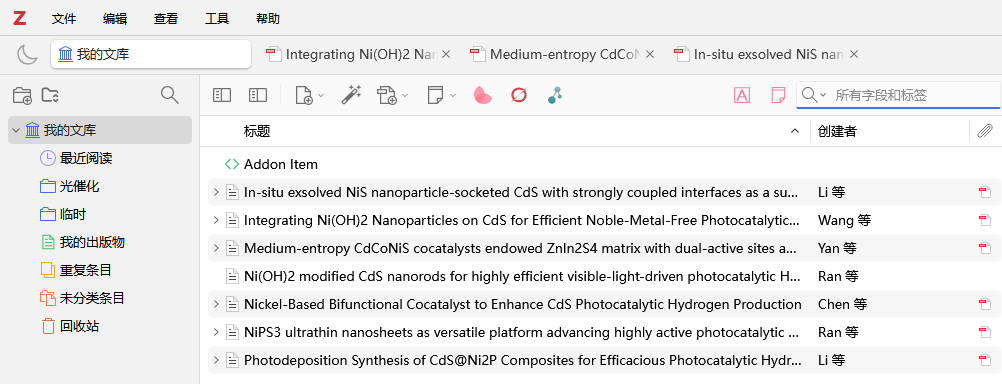
和实际的zotero文献信息一样
这样以后DeepSeek可以直接读取你Zotero里面的文献,包括PDF批注、笔记等等一切它能读懂的内容!!!
当然,只读文献还是太局限了,能不能让它帮我整理笔记、形成文献矩阵和文献综述呢?
当然可以!!!
可以搭配其他大佬开发的科研用Skills(技能),这个是给大模型指导的提示词
告诉他怎么样进行文献阅读、文献结构和内容分析、如何匹配事实证据、如何查找文献
总之,目前互联网上(尤其是GitHub)已经开源了许多科研类SKILL
我也整理了一些科研用SKILL
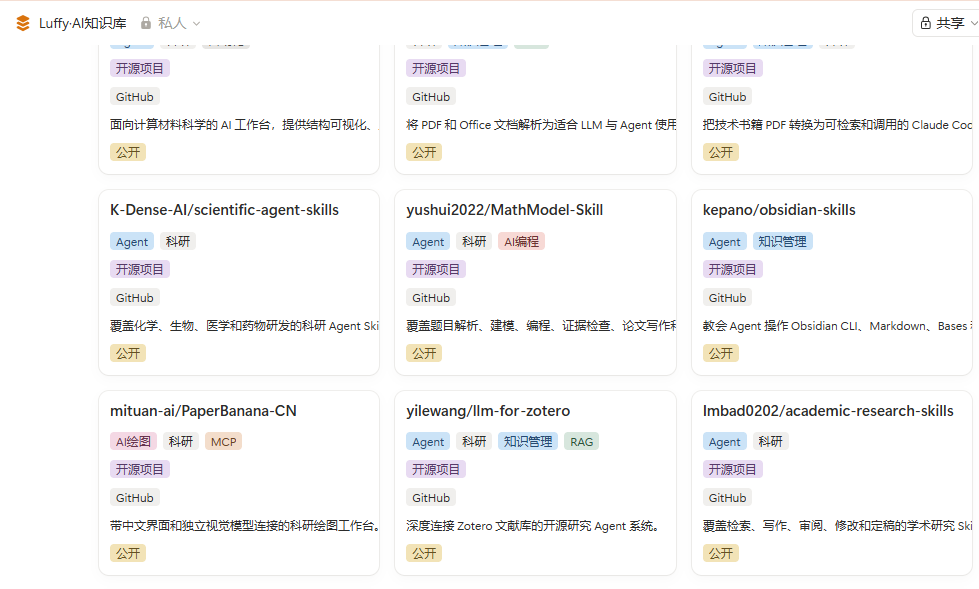
感兴趣的可以私我
但是怎么使用呢?
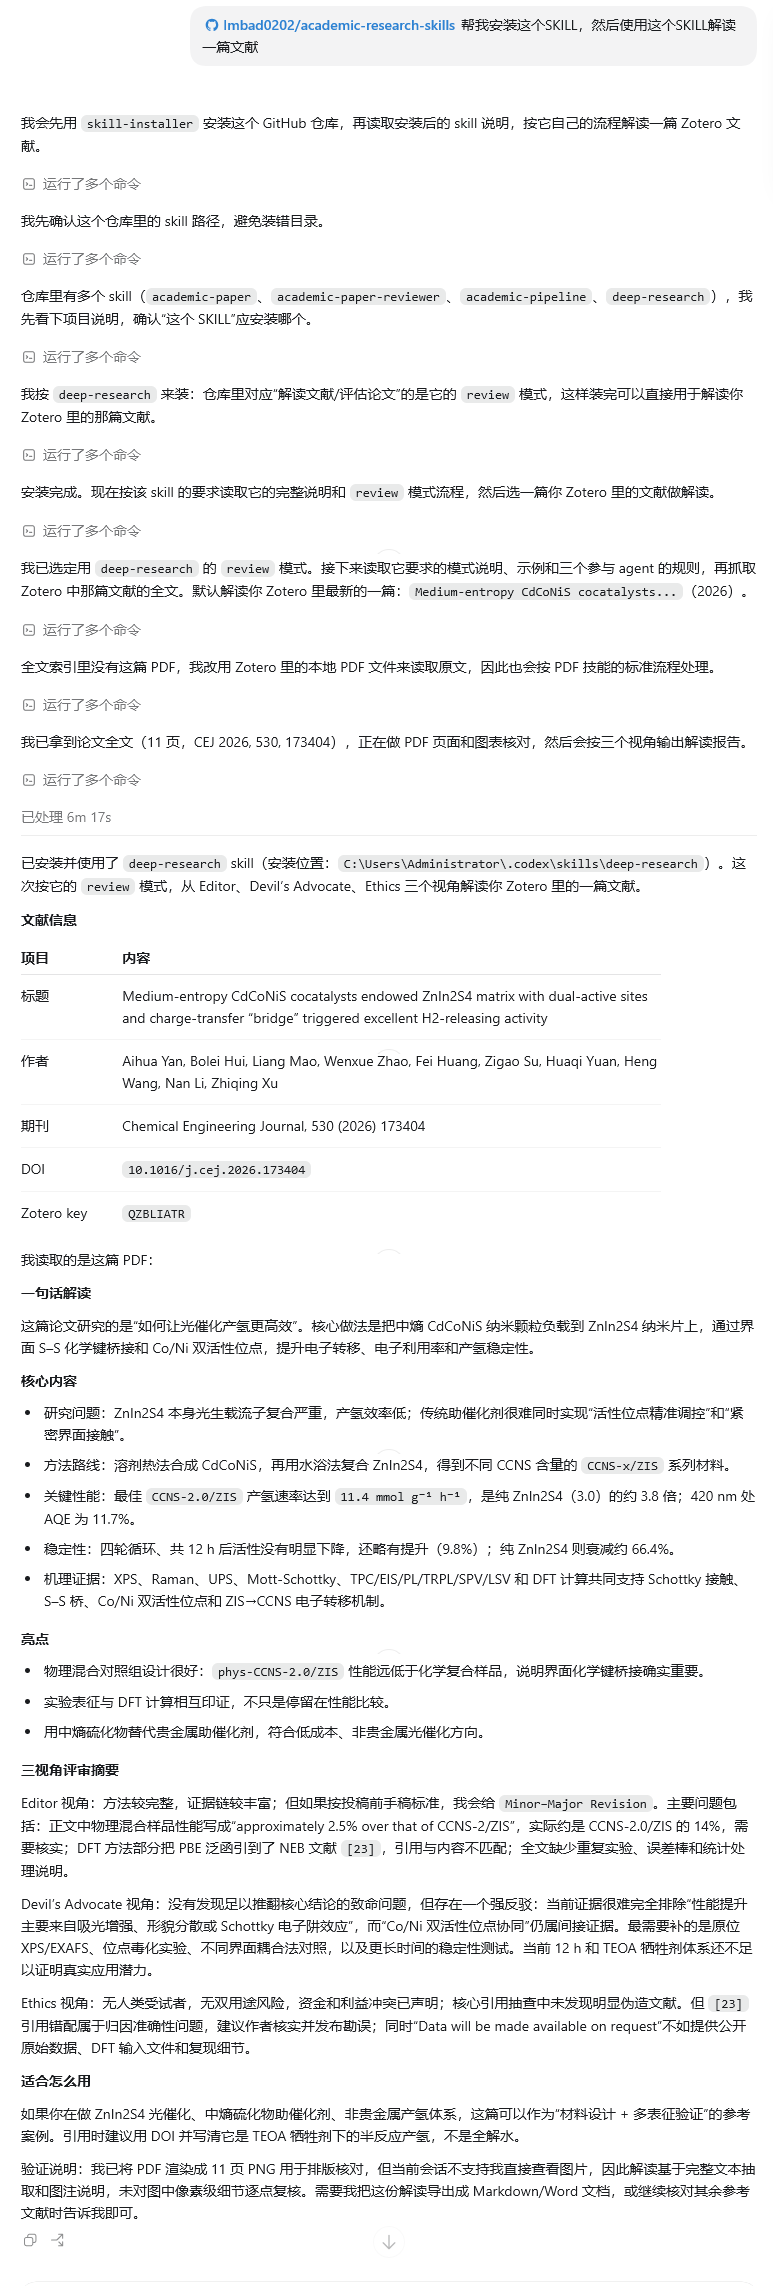
很简单,让DeepSeek帮你安装SKILL就好
比方说安装这个文献阅读到写作的全流程SKILL
他会调用技能的要求从审稿人、编辑者、领域专家等视角进行文献精读,他会调用本地PDF技能进行文献解析拆分成纯文本结构,你看DeepSeek文本模型也能读懂PDF附件
当然,使用SKILL是一种用法,还有一种用法是使用MCP、插件
我自己也做了一个MCP工具、也内置了文献解读、图表解读、文献管理SKILL
其中最重要的是搭建了一个文献解析桥梁——MinerU
这个是将PDF解析成人类和大模型可读的markdown标记语言
我做了这么一个工具,是为了减轻大模型帮我读文献的成本和负担
因为Zotero里的PDF附件直接发给大模型,虽然能读,但是token数量占据很多,而且不好做笔记整理和文献关联
之前已经有zotero插件如GPT Pro、LLM for Zotero做的也很好
但是对于经常让AI Agent管理文献,可能不够方便,
然后对于文献笔记的整理,我推荐使用Obsidian进行整理,这是做笔记和初期文献撰写比较方便的本地开源软件
所以我现在做的事就是在Codex里面使用技能查找文献,然后人为筛选文献,通过浏览器的zotero插件把文献自动化导入到zotero,然后在Codex利用CC Switch配置DeepSeek模型帮我解读和管理文献,然后把文献同步导入到Obsidian进行精读
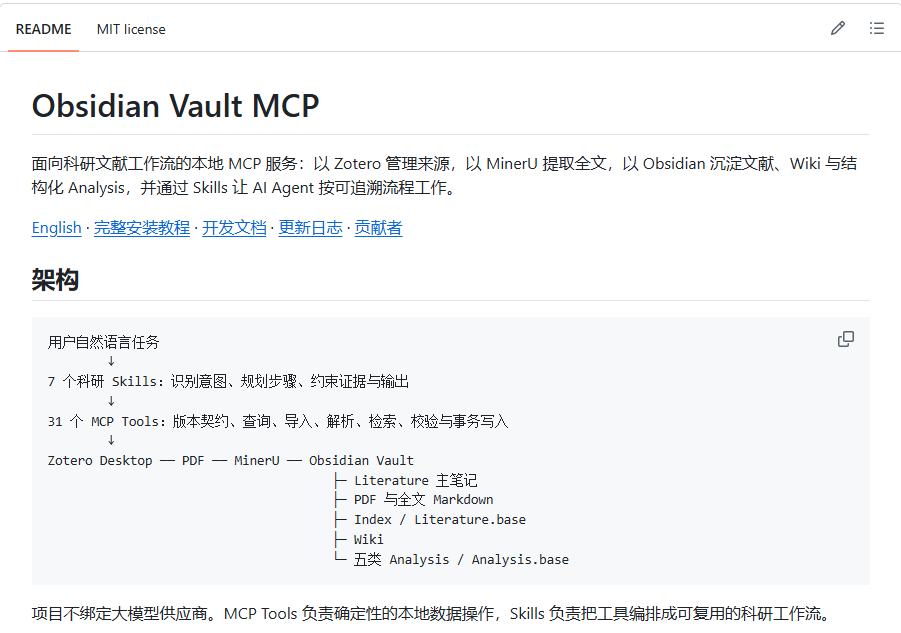
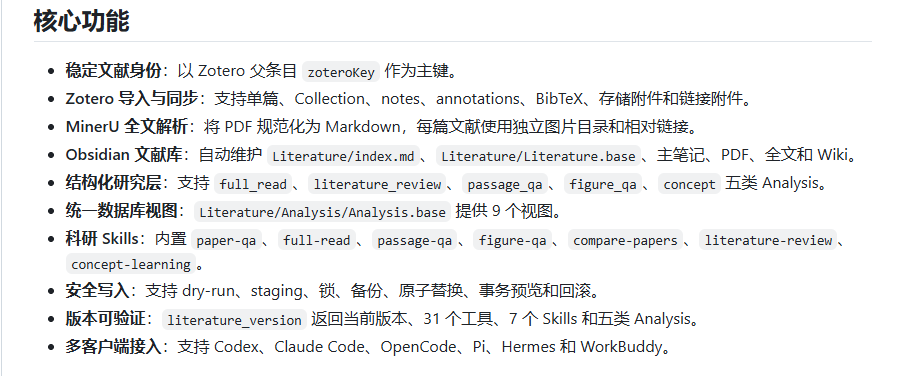
而我开发的这个Obsidian Vault MCP工具(见下文),就是在自动化这个流程,暴露给DeepSeek或者其他大模型使用,按照这个标准的流程更新每一篇zotero文献和笔记
安装 Obsidian Vault MCP
仅安装官方的 Zotero 插件,已经能读取大部分文献条目元数据
但读取结束后,内容通常只停留在当前对话中。为了把文献、PDF、全文、精读结果和综述长期沉淀到 Obsidian,可以继续安装 Obsidian Vault MCP。
项目地址:
版本要求 Python 3.10 以上,提供 31 个 MCP Tools、7 个科研 Skills 和 5 类结构化 Analysis,能够连接 Zotero、MinerU、Obsidian 与 Codex。
安装好Python和node.js后
使用CMD命令一键安装,没接触过命令行的小白可以直接把我上面参考地址发给Codex(DeepSeek)进行配置
参考提示词:
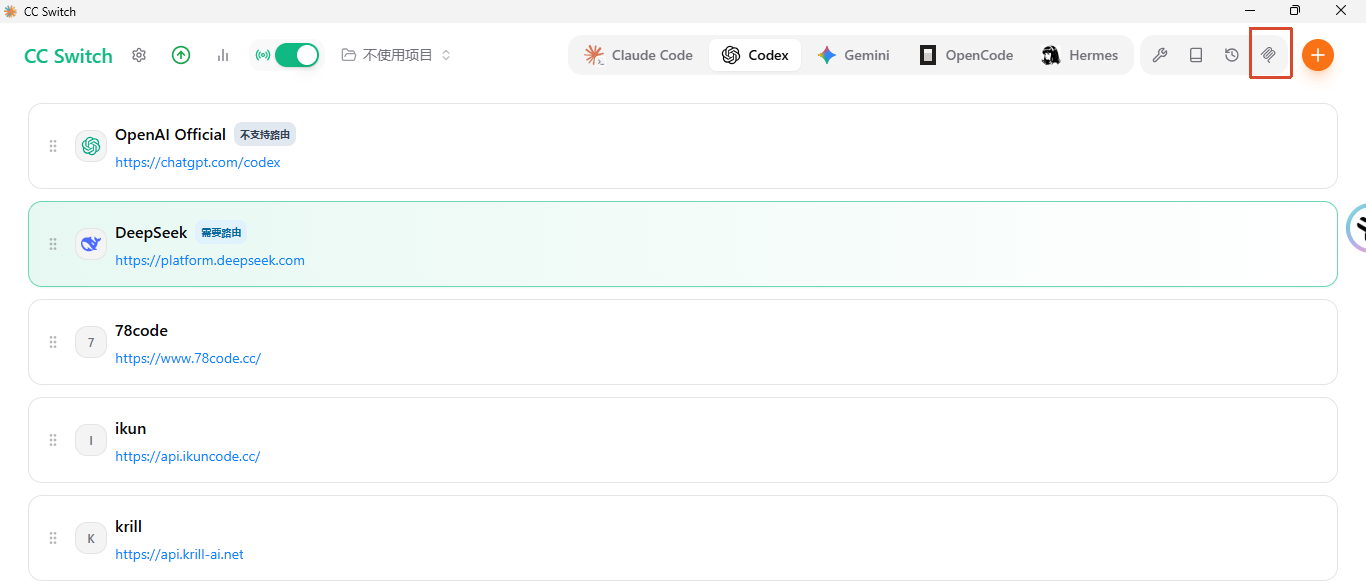
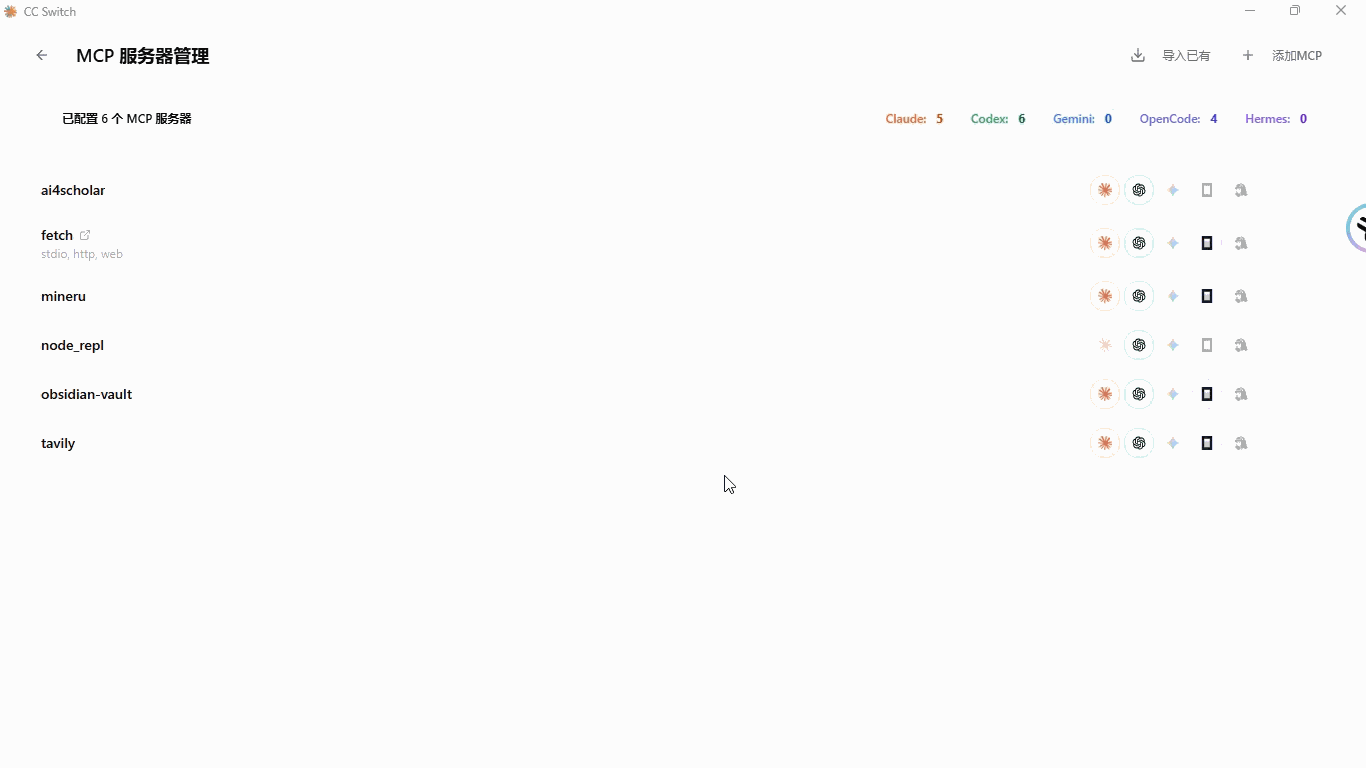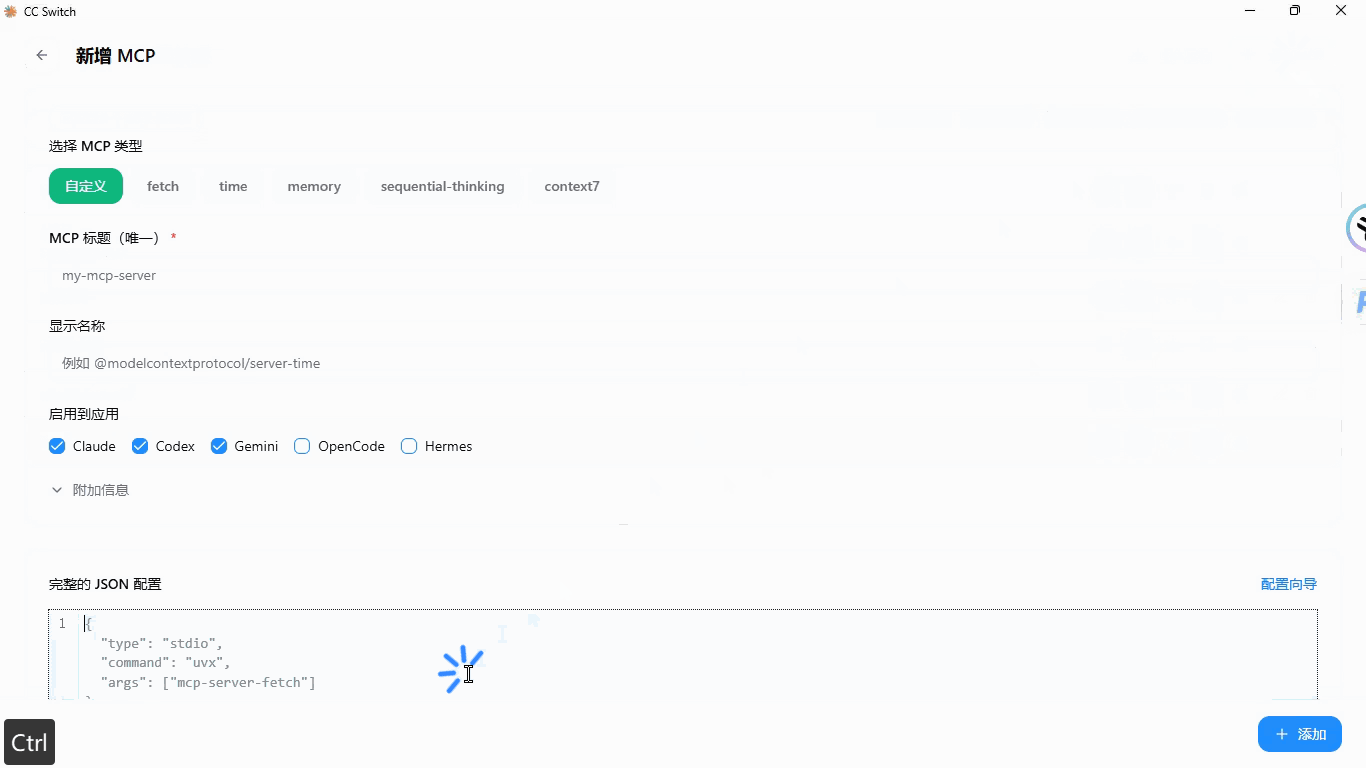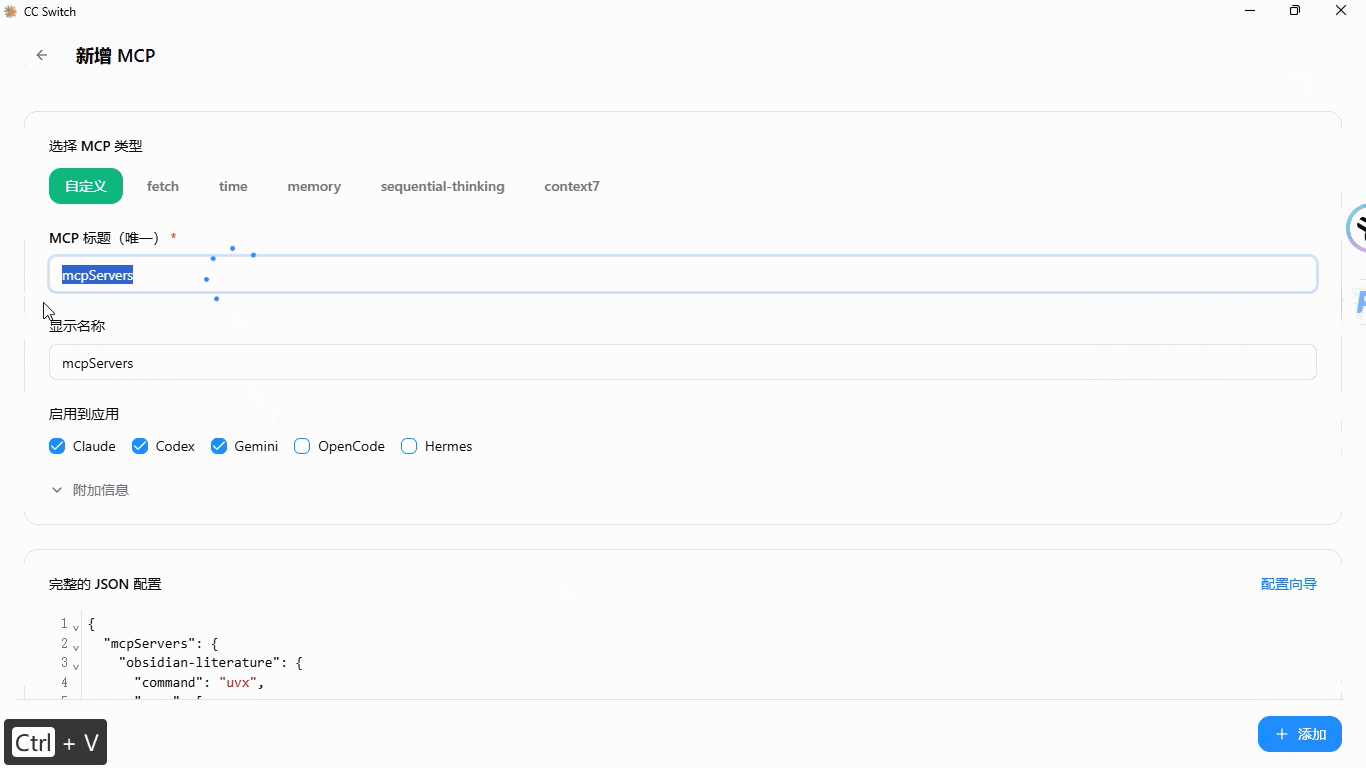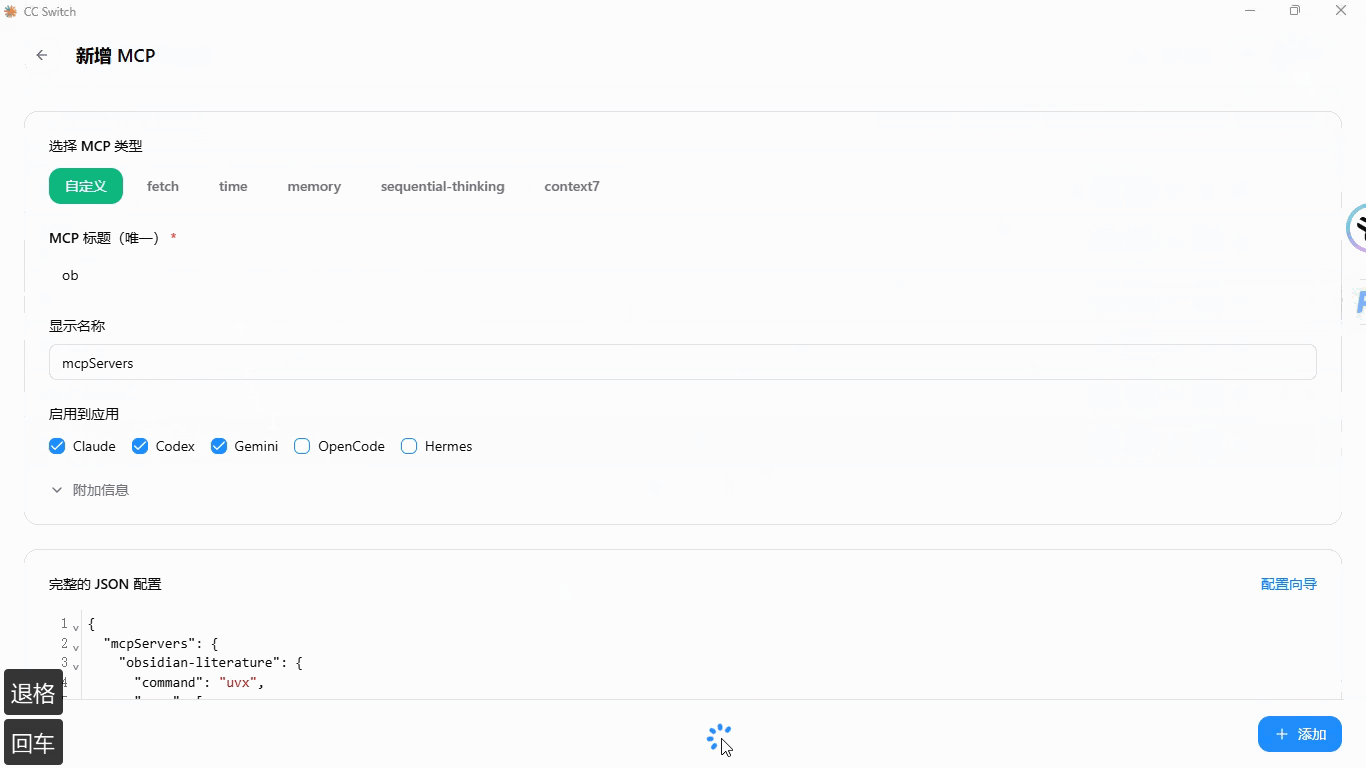
也可以自行使用CC Switch进行MCP配置
复制下面json代码
注意这里
"<VAULT_PATH>"双引号里面的内容等下粘贴后需要改成你的Obsidian实际vault仓库在CC Switch这里打开MCP配置页面
注意
MCP标题任意填写,能记住就行,但是json的vault参考一定要改为自己实际的参考地址,或者填auto
我还做了一期视频是展示如何使用WorkBuddy进行配置,实现WorkBuddy、Zotoro、Obsidian联动的完整教程
安装好后是这样子的形式
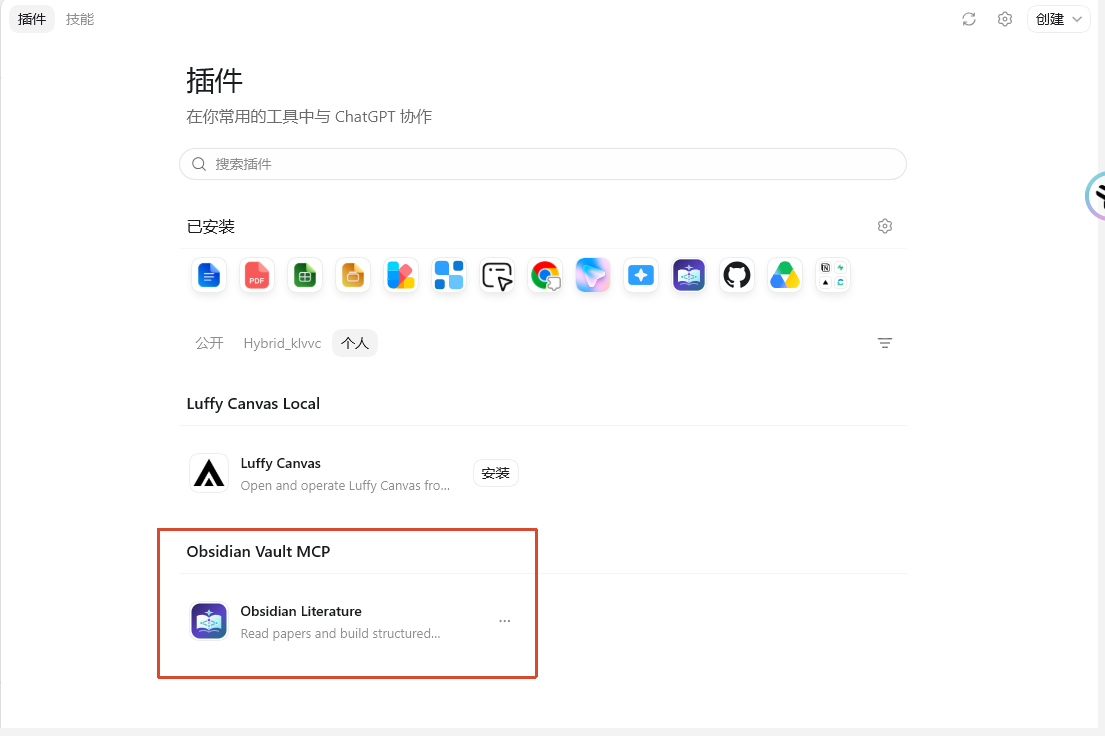
最后
总体来说,使用Codex接入DeepSeek的一个流程进行读取zotero文献的架构如下:
今天带大家完整的演示了一遍教程
手把手带你从零配置Codex接入DeepSeek读取zotero文献
相信在不久后的将来,读文献、找文献的效率会得到大大提升
人类要做的事情估计就剩下判断和审核把关
这或许才是科研大牛拿不走的护城河
好了,以上就是本期的全部内容啦,感谢你的喜欢和阅读
我是三木,欢迎下次访问
我,一直在这等你!
- 作者:三木
- 链接:https://luffysite.top/article/codex-deepseek-zotero111
- 声明:本文采用 CC BY-NC-SA 4.0 许可协议,转载请注明出处。
相关文章